IIoT Retrofit für Brownfield: Die skalierbare Connector Box für Industrie 4.0
by Michael Helfenstein Software-Entwickler21. Mai 2026· 14 Min. lesen
Einleitung
Die Digitalisierung der industriellen Produktion schreitet rasant voran. Viele Unternehmen stehen dabei vor der Herausforderung, bestehende Maschinen und Anlagen in vernetzte, datengetriebene Prozesse zu integrieren, ohne den Maschinenpark vollständig zu erneuern. Genau hier setzt das Konzept der IIoT Connector Box an: als skalierbarer Retrofit-Baukasten für Brownfield-Umgebungen.
In diesem Blogbeitrag beleuchte ich die zentralen Business-Anforderungen und Architekturentscheidungen, die bei einer solchen Lösung im Vordergrund stehen. Anschliessend zeige ich, wie eine mögliche Edge-Architektur für die Maschinendatenerfassung aufgebaut sein kann, welche technischen Bausteine sich dafür eignen und welche unterschiedlichen Lösungsansätze sich in der Praxis anbieten. Ziel ist es, einen realistischen Überblick zu geben und Denkanstösse für eine modulare, erweiterbare und zukunftsfähige Umsetzung zu liefern.
Business Anforderungen und Architekturentscheidungen im Fokus
Die erfolgreiche Umsetzung eines IIoT-Projekts beginnt mit den grundlegenden Architekturentscheidungen. Diese können jedoch nicht getroffen werden, ohne vorher die Business-Anforderungen zu kennen. Denn ohne konkretisierte, festgehaltene qualitative Anforderungen sowie das Ermitteln der fachlichen Ziele ist eine Software-Architektur nur die Hälfte wert. Denn nur was dem Business am Ende einen Mehrwert bietet, macht überhaupt Sinn, in Software zu giessen. Sobald dieses Verständnis vorhanden ist, kann die technische Grundlage geschaffen werden, um eine nachhaltige und zukunftssichere IIoT-Infrastruktur zu entwerfen, die zum Unternehmen passt. Also einfach gesagt: Wir müssen wissen, was das Business eigentlich wirklich will!
Jedes Unternehmen hat seine eigene IT-Umgebung, Anforderungen und Compliance-Vorgaben, die es zu berücksichtigen gilt. Ebenso sein eigenes Applikations-Ecosystem, das bereits im Einsatz ist. Im Idealfall kann man auf bereits eingesetzten, bekannten und funktionierenden Systemen aufbauen. Wenn es darum geht, Anlagendaten zu erfassen, zu visualisieren, zu verarbeiten und aus den gewonnenen Daten Mehrwert zu generieren, um diesen wieder in die Arbeitsprozesse einfliessen zu lassen, sind auch die Anforderungen an das OT-Netzwerk und die Sicherheit entscheidend bei der Auswahl der passenden Lösung. Hier gibt es sicherlich Gemeinsamkeiten aus der bestehenden IT-Umgebung, die übernommen werden können. Doch oft liegt der Teufel im Detail, denn es sind unterschiedliche Anforderungen vorhanden.
Bei der Auswahl einer passenden technischen Lösung zur Maschinen-Datenerfassung stehen folgende Fragestellungen im Vordergrund, die man sich stellen sollte:
- Welche Abhängigkeiten möchte man eingehen? Möchte man abhängig von einem der grossen Cloud-Anbieter sein, ist man bereit, Lizenzen zu zahlen, möchte man an einen der vielen IIoT-Plattform-Anbieter gebunden sein, oder setzt man voll auf einen Open-Source-Baukasten und erweitert diesen mit Eigenentwicklungen?
- Möchte man eine «Out of the box» Lösung oder eine individuelle Lösung? Obwohl nach meiner Meinung eine Brownfield Anbindung per se immer eine individuelle Lösung ist.
- Was sind relevante Prozessdaten, die mich bei der Prozessoptimierung, Wartung, Instandhaltung und Planung unterstützen können? Dies kann tatsächlich nicht so einfach beantwortet werden und bedingt allenfalls einen explorativen Ansatz.
- Welche Qualitäts-Anforderungen sind wichtig in meinem Umfeld? Idealerweise beschreibt man diese durch Qualitätsszenarien
- Wo werden die Produktionsdaten, Fertigungs- und Auftragsdaten mit den Maschinendaten zusammengeführt? Oft sind solche Schnittstellen nicht oder nur mangelhaft vorhanden. Einzelne Silo-Lösungen verhindern oft, schnell Mehrwert zu generieren, da der Zugriff nicht gewährleistet ist. Als Denkanstoss sei hier UNS [1] (Unified Namespace), welches stark von Walker Reynolds [2] geprägt wurde, als möglicher Lösungsansatz genannt.
- Wo sollen die Insights generiert werden und welchen Nutzen kann ich daraus ziehen? Der Nutzen ist ein zentraler Punkt der am besten vor der Umsetzung klar definiert wird.
- Welche Messintervalle sind für meine Use Cases sinnvoll? Reicht es aus, wenn die Daten alle 5 Minuten oder seltener erfasst werden, oder muss es jede Sekunde oder häufiger sein? Ist es allenfalls sinnvoller, am Edge Daten zu dezimieren oder eine Datenaufbereitung, eventuell Statistik oder auch ML, durchzuführen? Hier kann man die Business-Anforderungen und Qualitätsanforderungen heranziehen, um die richtige Entscheidung zu treffen.
- Muss ich auf den erlangten Insights reagieren können und wie schnell soll das geschehen? Ist ein direkter Einfluss auf den Produktionsprozess notwendig oder sollen Benachrichtigungen wie Events an weitere Systeme ausgelöst werden? Auch hier geben die Business Anforderungen die Antwort.
- Welche Systeme und Tools setzt man bereits ein und wie gut können diese in die neue Lösung integriert werden? Ist man bereit, Neues zu lernen, passendere Systeme einzuführen und neue Prozesse zu etablieren?
«Man muss sich im Klaren sein, dass es die «one fits it all»-Lösung nicht gibt. Bei der Auswahl der passenden Lösung sollte man nüchtern und realistisch an die Sache herangehen. Vor allem soll sie die Anforderungen und Bedürfnisse des Business erfüllen und nicht umgekehrt.»
Ein gutes Hilfsmittel für die Findung von Qualitätsmerkmalen kann zum Beispiel die ISO 25010 [3] sein. Sie kann dabei helfen, auf welche Merkmale zu achten ist. Dabei definiert man drei bis fünf top qualitative Merkmale, die für das Projekt am wichtigsten sind. Diese können zum Beispiel für die angestrebte IIoT-Connector-Box-Lösung folgende sein:
- Erweiterbarkeit – Es ist leicht, neue Funktionalität hinzuzufügen und die Lösung zu erweitern.
- Austauschbarkeit – Die Lösung ist modular aufgebaut und es können einzelne Teile daraus durch andere ersetzt werden, ohne dass dies zu grossen Problemen führt.
- Sicherheit – Die Lösung ist sicher und schützt die Daten vor unbefugtem Zugriff.
- Korrektheit – Die erfassten Informationen bilden die Realität ab
- Zuverlässigkeit – Die Lösung ist zuverlässig und funktioniert auch unter schwierigen Bedingungen.
Der nächste Schritt ist noch wichtiger: Qualitätsszenarien definieren und die Anforderungen des Business klar festhalten. Ich möchte hier jedoch nicht noch weiter ins Detail gehen, doch es ist wichtig, sich im Klaren zu sein, welche Ansprüche es an die Lösung gibt. Es liegt in der Natur der Sache, dass sich bei der Umsetzung einer IIoT Connector Box vieles um Schnittstellen und Integration dreht: zwischen der Maschine mit ihren Prozessen, dem Team von Menschen, welche diese beaufsichtigen und betreuen, dem Edge Device, welches die Daten verarbeitet, bis hin zur Unternehmensinfrastruktur und den Business-Prozessen, welche in bestehende Systeme wie ERP, SAP, EWM, WMS, MES, SCADA usw. integriert werden sollen.
«Jedoch nochmals klar gesagt: Die Business-Anforderungen sind die Basis und der Grund, warum wir überhaupt eine Lösung suchen. Die Technologie ist nur das Mittel zum Zweck und sollte nicht im Vordergrund stehen!»
Betrachtung einer IIoT Edge Device Architektur
Als Vorbereitung auf diesen Blogbeitrag habe ich mir Gedanken gemacht, wie eine mögliche Edge-Architektur für die Maschinendatenerfassung aussehen könnte. Dabei habe ich mich auf meine bereits gemachten Erfahrungen und die Betrachtung von unterschiedlichen IIoT-Plattform-Lösungen gestützt. Meiner Ansicht nach enthält eine Edge-Lösung im Grunde immer ähnliche zentrale Komponenten. Sie werden zwar je nach eingesetzten Technologien oder Anbieter unterschiedlich umgesetzt, enthalten jedoch dieselben Merkmale. In folgender Abbildung habe ich versucht, meine Sicht der wesentlichen Komponenten vereinfacht darzustellen:
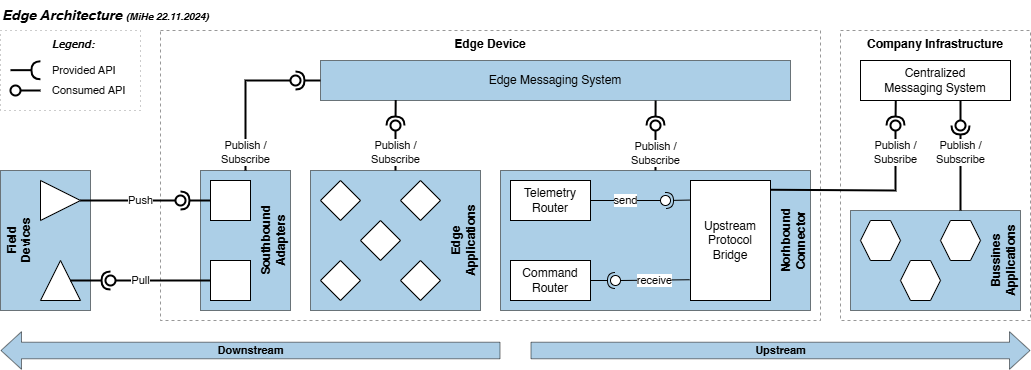
Wie in der Abbildung ersichtlich, sind drei zentrale Domänen zu erkennen: die Field Devices links, das können beispielsweise Fertigungsmaschinen oder Sensoren bei einer Huckepack-Lösung sein, also die Quelle. Das Edge Device, welches das Herzstück der Lösung ist und als Brücke zwischen Feld (OT) und der Unternehmensinfrastruktur IT dient [4]. Die Company Infrastructure rechts ist der Ort, an dem in der Regel die Daten mit den Business-Prozessen verschmolzen werden. Allenfalls sollen auch Kommandos an die Maschinen oder an das Edge Device zurückgegeben werden. Der primäre Upstream-Kommunikationskanal in dieser Übersicht ist in Richtung Company Infrastructure gerichtet, also primär das Versenden der Telemetry-Daten. In Richtung Downstream, also zum Edge Device und weiter zu den Field Devices, wird er für wenige Steuerkommandos und Konfigurationen genutzt. Es sei noch erwähnt, dass der Einfachheit halber die Sicherheit, Integrität oder auch für den Betrieb notwendige Komponenten nicht berücksichtigt wurden. Diese sind jedoch essenziell und müssen in einer produktiven Umsetzung berücksichtigt werden.
- Field Devices – Hier kann man beinahe jede Art von Hardware sowie verwendeten Protokollen und Schnittstellen erwarten. Gerade Automationshersteller verwenden hier oft eigene proprietäre Protokolle. Seit einigen Jahren hat sich jedoch der Standard OPC UA etabliert, welcher durch das Industriekonsortium OPC Foundation [5] standardisiert wird. Dieser ermöglicht es, Maschinen verschiedener Hersteller miteinander zu verbinden. Dies erlaubt auch eine einheitliche Schnittstelle für die Maschinendatenerfassung, unter anderem durch Companion-Spezifikationen. Die Weiterentwicklung durch die OPC UA Part 14 PubSub Spezifikation [6] ermöglicht es, Daten in Echtzeit zu erfassen und zu verarbeiten; zudem ist es ein Paradigmenwechsel von Pull zu Push. Bei Brownfield-Szenarien ist es jedoch oft nicht möglich, die Maschinen direkt mit OPC UA zu verbinden. Ein weiterer, in den letzten Jahren stark verbreiteter Standard ist MQTT, welcher durch OASIS Open [7] standardisiert wird. Es ist ein leichtgewichtiges Protokoll, das für die Kommunikation zwischen Geräten und Anwendungen in der Industrie 4.0 geeignet ist. Das Verstehen und Integrieren kann gerade in Brownfield-Szenarien eine Herausforderung sein; den notwendigen Aufwand sollte man nicht unterschätzen.
- Southbound Adapters – Um eine Kommunikation zwischen den Geräteprotokollen und dem Edge-System zu ermöglichen, ist der Einsatz passender Adapter notwendig. Diese helfen dabei, von einem Format ins andere zu überführen. Hier greift man, wenn immer möglich, auf bereits bestehende Lösungen zurück, seien diese Open Source oder von einem kommerziellen Anbieter. Als Beispiele seien hier Neuron [8], edgeConnector von Softing Industrial [9], OPC Foundation Cloud Initiative mit Projekten wie UA Cloud Publisher und UA Cloud Commander [10], opc-router von inray Industriesoftware GmbH [11] oder auch Node-Red mit entsprechendem Plugin [12] genannt.
- Edge Messaging System – Das Edge Messaging System ist die zentrale Komponente, welche die Kommunikation der unterschiedlichen Applikationen auf dem Edge Device ermöglicht. Man kann es auch als Implementierungsdetail betrachten, trotzdem kann es helfen, Informationen einfach zwischen den lokalen Applikationen auszutauschen. Gerade bei der Datenerfassung fallen oft hohe Datenmengen an, die als Stream am einfachsten zu verarbeiten sind. Auch hier hat sich in den letzten Jahren MQTT als Alltagswerkzeug etabliert. Einen wesentlichen Vorteil sehe ich in der einfachen Sichtbarkeit der vorliegenden Informationen durch das Verbinden eines MQTT-Clients wie MQTTX [13], der den gesamten Datenfluss problemlos sichtbar macht. Spannende Beispiele für Broker, welche MQTT v5 unterstützen oder Plugins dafür bereitstellen, sind: Eclipse Mosquitto [14], NanoMQ [15], EMQX (Edge) [16], HiveMQ Edge [17] oder Kafka mit Plugin [18]. Kann man darauf verzichten, wären auch andere Messaging-Systeme denkbar, wie zum Beispiel Nats [19], RabbitMQ [20] und Redis [21].
- Edge Applications – Hier positioniere ich die verschiedenen Applikationen, die auf dem Edge Device ausgeführt werden. Alles, was notwendig ist, um den geforderten Business Case zu erfüllen. Diese reichen von einfachen Aggregationen, Filterungen, Dezimierungen und Erkennungen bis hin zu Machine-Learning-Modellen. Ein gängiges Szenario sind Trigger, die schnell auf Field-Device-Informationen reagieren sollen, um eine bestimmte Aktion auszuführen, wie zum Beispiel eine Datenaufzeichnung zu starten oder jemanden zu informieren. Hier ist es wichtig, dass die Applikationen modular und flexibel aufgebaut sind. Das Edge Messaging System spielt dabei eine wichtige Rolle, um die Kommunikation zwischen den Applikationen zu vereinfachen. Auch hier ist es sinnvoll, zuerst abzuklären, ob es nicht bereits bestehende Lösungen für bekannte Problemstellungen gibt. Oft kann mit einer Rule Engine wie eKuiper [22] oder einem Low-Code-Tool wie Node-Red [12] bereits viel erreicht werden; diese geben eine gute Grundlage für die Weiterentwicklung einer individuellen Lösung. Gerade am Anfang geht es darum, schnell Mehrwert zu generieren und Field Devices besser zu verstehen. Während der Entwicklung und darüber hinaus ist es sehr hilfreich, Informationen besser zu verstehen, indem man diese sichtbar macht; dafür empfehle ich immer eine Time-Series-Datenbank wie InfluxDB [23] in Kombination mit Grafana [24].
- Northbound Connector – Hier befindet sich die Schnittstelle zur Unternehmensinfrastruktur, also dem Northbound. Die im Edge verarbeiteten Telemetry-Daten werden bestehenden Systemen bereitgestellt, damit diese weiterverarbeitet werden können. Durch Kommandos können Drittsysteme Informationen zurück an das Edge beziehungsweise weiter an die Field Devices senden. Hier gibt es sicherlich viele Möglichkeiten, je nach Anforderungen und bestehender Infrastruktur. Was bei Air-Gapped-Systemen sicherlich eine Herausforderung sein kann, aber auch bei In-House-Lösungen betrachtet werden sollte, ist, dass die Verbindung zum IT-Netzwerk nicht immer gewährleistet ist. Es kann durchaus sein, dass die Daten über einen längeren Zeitraum lokal gespeichert werden müssen, bevor sie weitergeleitet werden können. Hier sollte man darauf achten, dass das gewählte Messaging-System auch die Möglichkeit bietet, Daten lokal für eine bestimmte Zeit zwischenzuspeichern, ohne selbst dafür sorgen zu müssen.
- Centralized Messaging System – Sinnvoll ist der Einsatz eines zentralen Messaging-Systems. Dies hilft bei der Weiterverarbeitung der Daten, wie zum Beispiel beim Speichern in einer Datenbank oder beim Weiterleiten an andere Systeme. In letzter Zeit wird hier oft von einem Unified Namespace (UNS) [1] gesprochen. Dieser Begriff wurde durch Walker Reynolds [2] geprägt und beschreibt eine zentrale Struktur des Unternehmensgeschäfts und aller Ereignisse. Es ist der Ort, an dem der aktuelle Stand des Unternehmens lebt, also der Knotenpunkt, über den die intelligenten Dinge im Unternehmen miteinander kommunizieren. Man kann es auch als eine Art digitalen Zwilling sehen.
- Business Applications – Hier werden die Daten weiterverarbeitet und in bestehende Systeme integriert. Dies können ERP-Systeme, MES-Systeme, SCADA-Systeme, Datenverarbeitungssysteme, die Ablage in einen Data Lake, Alarmierungssysteme usw. sein.
Datenformat:
Ich möchte dabei speziell betonen, dass das zu wählende Datenformat einheitlich sein sollte. Dies erleichtert die Integration in bestehende Systeme und ermöglicht eine effiziente Verarbeitung der Daten. Gerade zum Start ist ein lesbares Format wie JSON hinsichtlich der Transparenz sehr hilfreich und kann mit JSON Schema [25] auf Gültigkeit geprüft werden. Bei grösseren Datenblöcken kann man sehr gut auf das spaltenorientierte, schemabehaftete und komprimierte Datenformat Parquet [26] zurückgreifen, welches von gängigen Datenverarbeitungstools unterstützt wird.
Was ich auf keinen Fall vorenthalten möchte: In den letzten Jahren hat sich Sparkplug [27] vermehrt etabliert, gerade im Zusammenhang mit Unified Namespace (UNS) [28]. Die breite Unterstützung hält sich jedoch immer noch in Grenzen und ist auf einige, jedoch grosse Anbieter wie beispielsweise HiveMQ [29] beschränkt. Sparkplug B, welches als Industriestandard gehandelt wird, basiert auf Version 2.2 und baut auf MQTT 3.1.1 auf, um Daten im industriellen Internet der Dinge (IIoT) zu strukturieren. Es definiert Namenskonventionen, Datenformate (Protobuf) und Zustandsüberwachung (Birth/Death Certificates), was die Integration von Sensoren und Geräten standardisiert, die Interoperabilität verbessert und die Konfiguration vereinfacht. Die aktuelle Version 3.0, welche Ende 2022 erschienen ist, unterstützt nun auch MQTT v5, was zusätzliche Funktionen und Verbesserungen bietet. Es wird jedoch sicherlich noch Zeit brauchen, bis diese Version in der Industrie weit verbreitet ist.
Die Umsetzung als eine Reise
Weiter möchte ich ein paar Gedanken zur Projekt-Umsetzung machen. Denn in der Realität ist dies oft komplexer als anfangs angenommen. Es ist nicht mein Anliegen, Angst zu schüren, sondern einfach übertrieben realistisch darzulegen, was einen erwarten kann. Es muss aber nicht in jedem Fall so sein!
Es gibt viele organisatorische Herausforderungen, die es zu meistern gilt. Ein Aspekt ist, dass oft viele unterschiedliche Parteien involviert sind. Fangen wir bei der Maschine an: Hier ist allenfalls der Maschinenhersteller, der eine passende Schnittstelle bereitstellt, oder bei einer älteren Anlage greift man einige Signale direkt im Schaltschrank ab oder montiert zusätzliche Sensorik, was dazu führt, dass mechanisches Talent gefragt ist. Der Elektriker oder Automatiker verdrahtet die Signale elektronisch. Der IIoT-Engineer verantwortet das Edge Device und die Applikationen, die darauf laufen. Es benötigt einen Netzwerktechniker, der die Freigabe im OT/IT-Netzwerk ermöglicht. Weiter kann es beim Sammeln von Daten dazu führen, dass ein Datenanalyst und Data Engineer involviert sind, um diese Daten zu verarbeiten. Sollte noch eine Applikation entwickelt werden, um eine passende Visualisierung zu bewerkstelligen, ist ein Frontend-Developer notwendig. Läuft dann die Infrastruktur allenfalls in einer Private Cloud, sind ein Cloud-Developer und auch noch das Cloud-Operations-Team involviert. Spätestens in diesem Moment wird dann oft der Enterprise-Architekt und Data-Architekt hellhörig und will sicherstellen, dass die Architektur den Unternehmensanforderungen entspricht. Sollte es dann noch ERP-Anbindungen geben, ist sicherlich auch ein weiteres Team involviert. Und wie wird das dann mit den Security- und Compliance-Anforderungen geregelt? Dabei habe ich die wichtigste Partei, die Stakeholder wie Lean-Manager, Produktionsleiter, Fertigungsleiter oder Teamleiter, noch gar nicht erwähnt.
Eine gute Kommunikation kann schwierig sein. Bei so vielen möglichen Parteien kann dies schnell zu Unklarheiten und Unverständnis führen. Es sollte darauf geachtet werden, dass kein Gärtchendenken entsteht und alle Beteiligten an einem Strang ziehen. Sollte es zu einem «Das ist dein Problem»-Denken kommen, wird nicht mehr miteinander gesprochen; dies verzögert eine Umsetzung unnötig. Gerade mit den unterschiedlichen Fachbereichen und deren unterschiedlichen Sprachen kann dies zu Fachbarrieren führen. Hier kann ein Mittelsmann oder Dolmetscher zwischen den Beteiligten weiterhelfen. Zu beachten ist, dass von Beginn weg ein klares Commitment von allen Beteiligten vorhanden ist, damit die Umsetzung nicht ins Stocken gerät.
Zentral ist eine vorhandene und klare Business-Anforderung. Ist ein IIoT-Projekt nicht klar businessgetrieben und werteorientiert ausgerichtet, verliert man sich sehr schnell in unbedeutenden und unnötigen technischen Details. Dies kann in der Umsetzung teuer werden und führt oft zu einem unzufriedenen Endresultat. Mein Tipp hier ist:
- Klein starten und wachsen
- Die richtigen Fragen stellen wie: Warum machen wir das? Was wollen wir damit erreichen?
- Schnell Wert generieren, auch wenn diese klein sein mögen
- Fehler machen und daraus lernen, das Gelernte mitnehmen und die Lösung weiterentwickeln
- Sichtbarkeit schaffen, damit alle Beteiligten den Fortschritt sehen können und motiviert bleiben
«Digitalisierung ist eine Reise und nicht ein Projekt. Klein starten und wachsen mit wertvollen Ergänzungen»
Welche Lösungsansätze gibt es?
Doch wie könnte eine konkrete Umsetzung einer IIoT Connector Box aussehen? Die folgenden Vorschläge basieren auf persönlichen Präferenzen und lassen den Hardware-Aspekt der Einfachheit halber aussen vor, da dies je nach Anwendungsfall variieren kann. Es zeigt auch auf, dass es, wie bereits erwähnt, nicht die «one fits it all»-Lösung gibt. Neben den hier aufgeführten Out-of-the-Box-Lösungen kann man diese sicherlich auch als Grundlage verwenden, um eine einfachere und individuelle Lösungsvariante zu entwickeln. Grundsätzlich empfehle ich die Verwendung von Docker-Containern, um die Applikationen auf dem Edge Device zu betreiben. Durch die Verwendung von unterschiedlichen Komponenten als Container lässt sich die Lösung modular und flexibel gestalten und ermöglicht es, einzelne Komponenten nach Bedarf zu verwenden und mit weiteren zu erweitern.
Der Open Source Ansatz
Eine gute Möglichkeit, eine IIoT Connector Box umzusetzen, ist die Verwendung von Open-Source-Lösungen. Die LF Edge (Linux Foundation Edge) [30] ist eine Dachorganisation, deren Ziel es ist, einen offenen, interoperablen Rahmen für Edge Computing zu schaffen, der unabhängig von Hardware, Chipsätzen, Cloud-Lösungen oder Betriebssystemen ist. Also die ideale Adresse, um eine passende Open-Source-Lösung zu finden. Wer sich bereits mit der Cloud Native Computing Foundation auskennt, wird hier schnell Parallelen finden und sich zurechtfinden.
Ein spannendes Projekt ist dabei EdgeX Foundry [31], welches eine flexible und modulare Plattform für die Entwicklung von Edge-Computing-Lösungen bietet. Das Projekt zielt darauf ab, einen schnellen Einstieg mit einem Blueprint zu ermöglichen, aber trotzdem die Offenheit zu haben, einzelne Services auszutauschen oder zu erweitern. In der Standardkonfiguration wird zum Beispiel der MQTT-Broker Eclipse Mosquitto [14] verwendet und als Rule Engine eKuiper [22].
Der kommerzielle Ansatz
Vielleicht denken einige dabei als Erstes an einen grossen Cloud-Anbieter wie Microsoft Azure. Obwohl ich mich selber als Microsoft-Jünger bezeichnen würde, bin ich immer mehr enttäuscht von den vermeintlich einfachen Lösungen, welche sich dann doch als sehr komplex und unkomfortabel herausstellen. Die oft vermeintlich attraktiven SaaS- oder PaaS-Lösungen sind zwar schnell im Unternehmen integrierbar, jedoch oft mit vielen Kompromissen behaftet, welche nicht notwendig wären.
Daher nenne ich zwei attraktive Lösungen, wobei beide teilweise auf Open-Source-Komponenten aufbauen, der Mehrwert jedoch erst mit einer Enterprise-Lizenz freigeschaltet wird:
- EMQX [16] ist eine hochskalierbare Enterprise-Lösung, welche auch in der eigenen Infrastruktur betrieben werden kann. Die Kommunikation basiert auf MQTT v5 und bietet alle notwendigen Funktionen für eine State-of-the-Art-IIoT- und Edge-Lösung. Es verwendet für die Device-Anbindung eine angepasste Version von Neuron [8] als Protocol Adapter und eKuiper [22] als SQL-basierte Rule Engine. Die Stärken liegen dabei klar bei der Vielzahl von Integrationen über Konnektoren zu bestehenden gängigen Open-Source-Systemen bis hin zu Cloud-PaaS-Services. Der zusätzliche Smart Hub erlaubt es, die Datenintegrität in unterschiedlichen Formaten zu gewährleisten, indem er die Daten auf Gültigkeit prüft oder sie ins korrekte Format transformiert, bevor sie weiterverarbeitet werden.
- HiveMQ [29] ist quasi der Goldstandard für MQTT-Broker in der Industrie. Auch hier wird neben dem eigentlichen Produkt des Brokers die Möglichkeit für eine Edge-Lösung geboten, welche auf MQTT v5 basiert. Es werden gängige Protocol Adapter zur Verfügung gestellt. Der Data Hub übernimmt hier die Funktion der Datenvalidierung und der Fokus liegt auf der Erfüllung von Policy-Anforderungen. Die klaren Stärken kommen meiner Meinung nach mit dem 2025 eingeführten Produkt HiveMQ Pulse [32]. Dieses ermöglicht es, die Daten in Echtzeit zu analysieren, und integriert den Unified Namespace (UNS) [1]– Ansatz direkt in die Lösung. Genial dabei ist, dass dies über eine grafische Oberfläche ermöglicht wird, welche es auch Nicht-Entwicklern erlaubt, die Daten zu verstehen und zu nutzen.
Fazit
«Technologie alleine bringt noch keinen Vorteil. Als erstes braucht es die Aufgabenstellung (Problem) und den passenden Use Case dazu. Danach kommt die Lösung.»
Eine IIoT Connector Box ist kein Produkt, das man einfach einsetzt und damit ist alles gelöst. Sie ist vielmehr ein Architektur- und Umsetzungsansatz, mit dem bestehende Brownfield-Anlagen schrittweise in eine moderne, vernetzte Produktionslandschaft überführt werden können. Der grösste Hebel entsteht dann, wenn Business-Ziele, OT/IT-Anforderungen und technische Umsetzung von Anfang an gemeinsam gedacht werden.
Die in diesem Beitrag gezeigten Bausteine sollen helfen, die Komplexität greifbar zu machen: von den Feldschnittstellen über Messaging und Edge-Applikationen bis zur Integration in bestehende Unternehmenssysteme. Ob Open Source, kommerzielle Plattform oder eine Kombination daraus: Entscheidend ist nicht das Tool selbst, sondern wie gut die gewählte Lösung zur eigenen Organisation, zu den vorhandenen Kompetenzen und zu den priorisierten Use Cases passt.
Wer mit Retrofit starten möchte, fährt in der Praxis meist mit einem iterativen Vorgehen am besten:
- Einen klaren, messbaren Use Case wählen
- Mit einer kleinen, modularen Lösung starten
- Datenqualität und Datenverständnis früh sicherstellen
- Erfolgreiche Muster standardisieren und gezielt skalieren
So wird aus einem technischen Experiment Schritt für Schritt eine belastbare IIoT-Fähigkeit mit echtem Mehrwert für Produktion, Instandhaltung und Business.
Quellenverzeichnis
- [1] Unified Namespace (UNS) (https://virtualfactory.online)
- [2] Walker Reynolds (https://www.linkedin.com/in/walkerdreynolds/)
- [3] ISO 25010 System and software quality models (https://iso25000.com/index.php/en/iso-25000-standards/iso-25010)
- [4] IT / OT (https://de.wikipedia.org/wiki/Industrielle_Informationstechnologie#Strukturkonzept)
- [5] OPC Foundation (https://opcfoundation.org)
- [6] OPC UA PubSub Spezifikation (https://reference.opcfoundation.org/Core/Part14/docs/)
- [7] MQTT Spezifikation (https://mqtt.org/mqtt-specification/)
- [8] Neuron (https://github.com/emqx/neuron)
- [9] Softing Industrial (https://softing.com)
- [10] OPC Foundation Cloud initiative mit Projekten wie UA Cloud Publisher und UA Cloud Commander (https://opcfoundation.org/cloud/)
- [11] OPC Router (https://www.opc-router.com/)
- [12] Node-Red (https://nodered.org/)
- [13] MQTTX (https://mqttx.app/)
- [14] Eclipse Mosquitto (https://mosquitto.org)
- [15] NanoMQ (https://nanomq.io/)
- [16] EMQX (https://www.emqx.com/)
- [17] HiveMQ Edge (https://www.hivemq.com/products/hivemq-edge/)
- [18] Apache Kafka (https://kafka.apache.org/)
- [19] Nats (https://nats.io/)
- [20] RabbitMQ (https://www.rabbitmq.com/)
- [21] Redis (https://redis.io/)
- [22] eKuiper – Stream Processing at the IoT Edge (https://ekuiper.org/)
- [23] InfluxDB (https://www.influxdata.com/)
- [24] Grafana (https://grafana.com/)
- [25] JSON Schema (https://json-schema.org/)
- [26] Parquet (https://parquet.apache.org/)
- [27] Sparkplug (https://sparkplug.eclipse.org/)
- [28] Implementing Unified Namespace (UNS) With MQTT Sparkplug (https://www.hivemq.com/blog/implementing-unified-namespace-uns-mqtt-sparkplug/)
- [29] HiveMQ (https://www.hivemq.com/)
- [30] LF Edge (https://lfedge.org/)
- [31] EdgeX Foundry (https://www.edgexfoundry.org/)
- [32] HiveMQ At ProveIt! 2026 | Multi-Site Benchmarking with a UNS: From Edge Signals to Global OEE Levers (https://www.youtube.com/watch?v=pit-iierKFc&t=2s)
Schreiben Sie einen Kommentar