Performance messbar machen mit Grafana k6
In vielen Softwareprojekten ist die Performance, insbesondere das Zeitverhalten (Antwortzeiten) und die Kapazität (Durchsatz), eine zentrale Qualitätsanforderung. Dennoch werden Qualitätsaspekte in der Praxis häufig nachrangig behandelt und oft erst spät im Projekt systematisch überprüft.
Gerade im heutigen KI-getriebenen Entwicklungsalltag gewinnt dieses Thema zusätzlich an Bedeutung. Wenn Software zunehmend KI-gestützt entwickelt wird und Code automatisiert entsteht, wird ein solides Testgerüst unverzichtbar. Ohne kontinuierliche Validierung besteht die Gefahr, dass sich Qualitätsprobleme unbemerkt einschleichen und erst spät auffallen.
Dabei haben gerade diese Qualitätseigenschaften einen entscheidenden Einfluss auf den Markterfolg eines Produkts. Zum Beispiel wird ein Auto selten allein wegen seiner Funktionalität gekauft. Die meisten Fahrzeuge erfüllen ihren funktionalen Zweck, indem sie Personen von A nach B bringen. Sie unterscheiden sich aber erheblich in Beschleunigung, Komfort und Effizienz. Genau diese (Qualitäts-) Eigenschaften sind oft kaufentscheidend.
Qualität als Teamverantwortung
Qualitätseigenschaften betreffen das ganze Team und sollten daher auch allen Beteiligten bekannt sein:
- Der Product Owner muss deren Relevanz verstehen und priorisieren
- Entwickler müssen Architektur und Implementierung darauf ausrichten
- Der Betrieb muss die nötige Infrastruktur bereitstellen
Es bringt also wenig, wenn beim Projekt-Kickoff Ziele definiert und auf einer Confluence-Seite abgelegt werden, die im Laufe des Projekts in Vergessenheit geraten.
Diese Qualitätsziele sollten stetig präsent sein und das Team bei wichtigen Entscheidungen als eine Art Polarstern in Richtung eines erfolgreichen Projektabschlusses leiten.
Qualität entsteht nicht zufällig, sondern durch bewusste Entscheidungen, geeignete Architekturprinzipien und den Einsatz passender Werkzeuge. Eines dieser Werkzeuge kann Grafana k6 sein, auf welches in diesem Artikel genauer eingegangen wird.
Qualitätsszenarien als Grundlage
Um Qualitätsanforderungen im Alltag greifbar zu machen, bieten sich Qualitätsszenarien an. Diese definieren präzise, was „gute Performance“ im jeweiligen Kontext bedeutet und machen Annahmen explizit und nachvollziehbar. Denn was beispielsweise Netflix unter „guter Performance“ versteht, kann sich stark vom Verständnis eines Schweizer Kleinunternehmens unterscheiden.
Ein Beispiel eines Qualitätsszenarios für eine Suchanfrage in einer Webapplikation wäre folgendes:
- Quelle: Benutzer
- Stimulus: Sendet eine Suchanfrage
- Artefakt: Backend-API
- Umgebung: Normale Last (100 gleichzeitige Nutzer)
- Reaktion: System liefert Suchergebnisse
- Messgröße: p99 < 300ms
Die 99. Perzentile bedeutet hier, dass 99% aller Anfragen in weniger als 300 ms beantwortet werden und nur 1 % länger dauern dürfen. Dieses Mass wird bevorzugt für solche Tests herangezogen, da es robuster gegen Ausreisser ist und daher aussagekräftiger als beispielsweise eine durchschnittliche Antwortzeit.
Solche Szenarien dienen direkt als Spezifikation für automatisierte Lasttests, die regelmässig, beispielsweise in einer CI/CD-Pipeline, ausgeführt werden. So bleibt der Ist-Zustand der Performance jederzeit sichtbar und Qualitätsziele werden aktiv überprüft. Performance-Probleme sind selten gleichmässig verteilt, sondern sie zeigen sich oft nur in bestimmten Szenarien oder Lastbereichen. Solche Engpässe (z. B. N+1 Queries, Thread Pool Starvation etc.) können durch gezielte Lasttests frühzeitig erkannt und beseitigt werden. Zudem ermöglichen diese Tests gezielte Optimierungen mit einer klar definierten «Gut-genug»-Messlatte.
Lasttests mit Grafana k6
Performance-Probleme sind besonders kritisch, da sie sich unter Last oft nicht linear verhalten und in späteren Projektphasen nur mit hohem Aufwand oder grundlegenden Architekturänderungen behoben werden können. Um dem frühzeitig vorzubeugen, sollten Lasttests von Beginn an etabliert werden. Grafana k6 bietet dafür ein geeignetes Werkzeug.
k6 ist ein leichtgewichtiges, entwicklerfreundliches Tool für skriptbasierte Lasttests in JavaScript. Es lässt sich gut in CI/CD-Pipelines integrieren und ermöglicht reproduzierbare Performance-Tests. Damit kann eine definierte Last gegen ein Testsystem ausgeführt werden, während Reaktionszeiten und Fehlerverhalten gemessen werden. Zwei zentrale Lastmodelle stehen dabei im Fokus:
Konstant kontrollierte Last: Arrival-Rate-Modell
Beim Arrival-Rate-Modell wird definiert, wie viele Requests pro Zeit erzeugt werden sollen. Um einen sinnvollen Test für das Qualitätsszenario zu definieren, muss die Last abgeschätzt werden, die durch Nutzer erzeugt wird. Wenn das System bereits in Betrieb ist, können diese Werte gemessen werden. Falls nicht, müssen sie anhand des erwarteten Nutzerverhaltens geschätzt werden.
Wenn im Beispiel angenommen wird, dass ein User im Durchschnitt alle zwei Sekunden eine Suchanfrage stellt, ergeben sich bei 100 gleichzeitigen Nutzern ca. 50 Requests pro Sekunde. Das Qualitätsszenario könnte folgendermassen getestet werden:
export const options = {
  scenarios: {
    search_scenario: {
      executor: 'constant-arrival-rate',
      rate: 50,
      timeUnit: '1s',
      duration: '20m',
      preAllocatedVUs: 100,
      maxVUs: 150,
    },
  },
  thresholds: {
    http_req_duration: ['p(99)<300'],
  },
};

export default function () {
  http.get('https://example.com/api/search?q=test');
}
Bei diesem Test werden über 20 Minuten hinweg konstant 50 Requests pro Sekunde gegen das System ausgeführt, unabhängig davon, wie schnell das System antwortet. Dabei wird die Antwortzeit jeder Anfrage gemessen und am Ende geprüft, ob mindestens 99 % der Requests unter 300 ms liegen. Dieses Modell eignet sich besonders, um Systemgrenzen unter kontrollierten Bedingungen zu identifizieren. Der Nachteil davon ist, dass es weniger realistisch im Hinblick auf das wirkliche Nutzerverhalten ist.
Beispiel: Testergebnis interpretieren
Anbei ist ein beispielhaftes Testresultat von einem arrival-rate Test ersichtlich:
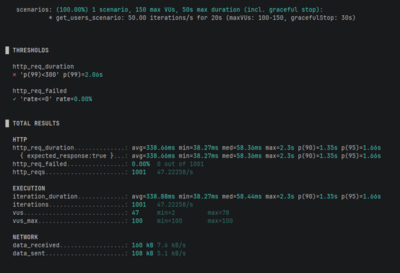
Im Testresultat liegt die 99. Perzentile der Antwortzeiten bei 2.06 Sekunden (http_req_duration), womit das definierte Ziel von 300 ms deutlich verfehlt wird. Das bedeutet, dass das System die definierten Qualitätsanforderungen aktuell nicht erfüllt. Das Ergebnis zeigt klar, dass die aktuelle Lösung den Qualitätsansprüchen nicht gerecht wird und eine Überarbeitung notwendig ist. Dadurch erhält das Team kontinuierlich Feedback zur tatsächlichen Systemqualität, was auch das Verantwortungsgefühl für die Qualität der Software im gesamten Team stärkt.
Realistische Nutzerlast: VUs-Modell (virtual users)
Beim VUs-Modell wird eine feste Anzahl virtueller Benutzer simuliert, die kontinuierlich Aktionen ausführen:
vus: 50,
duration: '20m'
Hier führen 50 Nutzer für 20 Minuten kontinuierlich Aktionen aus.
Die tatsächliche Last hängt jedoch vom Skriptverhalten und den Antwortzeiten der API ab. Wenn das System langsamer wird, benötigen die virtuellen Nutzer länger für ihre Iterationen, wodurch automatisch weniger Requests pro Sekunde entstehen. Dadurch ist die erzeugte Last nicht konstant.
Ein realistisches Qualitätszenario für einen Webshop könnte folgendermassen aussehen:
- Quelle: Benutzer
- Stimulus: Führt Einkauf durch (Login, Produkt wählen, Checkout)
- Artefakt: Gesamtsystem (Frontend + Backend-API)
- Umgebung: Normale Last (50 gleichzeitige Nutzer)
- Reaktion: Bestellung wird erfolgreich abgeschlossen
- Messgröße: ≥ 99 % der Flows erfolgreich & p95 < 400ms pro Schritt
Ein solcher User Flow abstrahiert die fachliche Sicht. Die daraus entstehende Systemlast kann je nach Implementierung deutlich höher sein als die Anzahl der simulierten Schritte vermuten lässt. Ein Testskript dafür könnte in k6 in etwa so aussehen:
import http from 'k6/http';
import { sleep, check, group } from 'k6';

export const options = {
  vus: 50,
  duration: '20m',
  thresholds: {
    http_req_duration: ['p(95)<400'],
    http_req_failed: ['rate<0.01'],
  },
};

const BASE_URL = 'https://example.com';

export default function () {
  let authToken = '';

  group('Login', () => {
    let res = http.post(`${BASE_URL}/api/login`, JSON.stringify({
      username: 'testuser',
      password: 'testpassword',
    }), {
      headers: { 'Content-Type': 'application/json' },
    });

    check(res, { 'login successful': (r) => r.status === 200 });

    authToken = res.json('token');
  });

  sleep(1);

  const authHeaders = {
    headers: {
      'Content-Type': 'application/json',
      'Authorization': `Bearer ${authToken}`,
    },
  };

  group('Produkt anzeigen', () => {
    let res = http.get(`${BASE_URL}/api/products/123`, authHeaders);
    check(res, { 'product loaded': (r) => r.status === 200 });
  });

  sleep(1);

  group('In Warenkorb legen', () => {
    let res = http.post(
      `${BASE_URL}/api/cart`,
      JSON.stringify({
        productId: 123,
        quantity: 1,
      }),
      authHeaders
    );
    check(res, { 'added to cart': (r) => r.status === 200 });
  });

  sleep(1);

  group('Checkout', () => {
    let res = http.post(
      `${BASE_URL}/api/checkout`,
      JSON.stringify({
        paymentMethod: 'credit_card',
      }),
      authHeaders
    );
    check(res, { 'checkout successful': (r) => r.status === 200 });
  });

  sleep(2);
}
Bei realistischen Tests sollte berücksichtigt werden, dass Nutzer unterschiedliche Pfade durchlaufen (z. B. Abbruch vor Checkout oder mehrere Produkte im Warenkorb), um realistischere Lastprofile zu erzeugen.
Die group()-Funktion in k6 dient dazu, einzelne Schritte eines User-Flows logisch zu strukturieren und messbar zu machen. Anstatt nur einzelne HTTP-Requests zu betrachten, werden zusammengehörige Aktionen wie etwa „Login“, „Produkt anzeigen“ oder „Checkout“ als zusammenhängende Einheiten modelliert. Das hat zwei wesentliche Vorteile:
Erstens werden die Resultate im Reporting nicht nur auf Request-Ebene sichtbar, sondern auch pro Gruppe aggregiert. Dadurch lässt sich erkennen, welcher Teil des User-Flows die meiste Latenz verursacht oder Fehler erzeugt. Ein langsamer Checkout fällt so sofort auf, selbst wenn einzelne API-Calls darin unauffällig wirken.
Zweitens verbessert group() die Lesbarkeit und Struktur der Tests erheblich. Gerade bei End-to-End-Szenarien mit mehreren Schritten wird der Test dadurch näher an der fachlichen Sicht des Users modelliert. Der Test beschreibt nicht mehr nur technische Requests, sondern reale Nutzeraktionen.
In Kombination mit Thresholds kann so sogar definiert werden, dass nicht nur einzelne Requests, sondern komplette Prozessschritte (z. B. Checkout-Flow) bestimmte Performance-Ziele einhalten müssen.
Die „sleep“-Aufrufe zwischen den Requests dienen der Modellierung der sogenannten Think-Time der Nutzer. Damit ist die Zeit gemeint, die ein echter Benutzer zwischen zwei Aktionen benötigt, um Inhalte zu lesen, zu verarbeiten oder eine Entscheidung zu treffen.
In realen Systemen klicken Nutzer nicht im Sekundentakt durch eine Anwendung, sondern verweilen auf Seiten, vergleichen Produkte oder überlegen sich den nächsten Schritt. Genau diese Verzögerungen werden durch sleep() im Test simuliert.
Dieser Beispiel-Test simuliert 50 gleichzeitige Nutzer, die den Bestellprozess wiederholt durchlaufen. So ein Test kann wertvoll für die Ermittlung der End-to-End Performance in einem System oder für realistische Simulation von User-Flows sein. Daraus kann abgeleitet werden, wie sich das System für echte Nutzer anfühlen wird.
Visualisierung mit Grafana Dashboards
Da k6 aus dem Hause Grafana kommt lässt es sich nahtlos mit Grafana-Dashboards integrieren. Typische Visualisierungen sind:
- Antwortzeiten (p95 / p99)
- Fehlerquoten
- Requests pro Sekunde
Das kann dann beispielsweise folgendermassen aussehen:
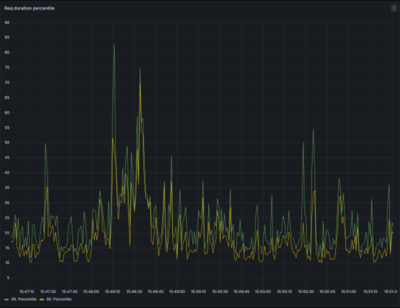
Darauf lassen sich p95 und p99 der Antwortzeiten über eine gewisse Zeitspanne erkennen. Besonders wertvoll wird dies, wenn reale Produktionsdaten zur Verfügung stehen. In dieser Situation können holistische Messungen gemacht und die korrekten Ist-Werte ermittelt werden. Auf dieser Basis werden Trends sichtbar und Verschlechterungen früh erkannt. Beispielsweise ist ein kontinuierlicher Anstieg der p95-Latenz bei gleichbleibender Last oft ein frühes Indiz für Ressourcenengpässe oder ineffiziente Abläufe. Weiter kann man die Produktionsmesswerte mit den Testergebnissen abgleichen und daraus wertvolle Erkenntnisse ziehen. Wenn beispielsweise die Daten aus der Realität mit den Testergebnissen auseinanderdriften, sollte man die Tests nochmals überarbeiten und so gut wie möglich an die Gegebenheiten (kontinuierliche Last, Lastspitzen etc.) aus der «echten Welt» anpassen.
Synthetische Lasttests können reales Nutzerverhalten nur approximieren, aber sie ersetzen keine Produktionsmetriken, sondern ergänzen diese. Erst die Kombination aus beiden liefert ein vollständiges Bild über das Systemverhalten.
Wichtige Punkte bei der Einführung von Lasttests
In vielen Projekten werden Lasttests erst kurz vor dem Go-Live durchgeführt, also zu einem Zeitpunkt, an dem grundlegende Architekturprobleme kaum mehr wirtschaftlich lösbar sind. Daher zahlt es sich langfristig aus, schon beim Projektanfang entsprechende Lasttests aufzusetzen, welche dann über den gesamten Projektzyklus hinweg die Qualität der Software sicherstellen.
Da die Resultate dieser Lasttests sehr stark von der Umgebung abhängen, in der sie ausgeführt werden, sollte die möglichst nahe an der Produktivumgebung sein. Daher lohnt es sich, eine Testumgebung für Lasttests aufzusetzen. Durch das Ausführen auf der produktionsähnlichen Testumgebung bekommt man wiederholbare und aussagekräftige Resultate.
Weiter sind gezielte Aufwände für die Spezifikation dieser Qualitätsszenarien und der entsprechenden Tests erforderlich. Dabei geht es darum, ein erwartetes, realistisches Lastverhalten abzuschätzen, was ohne echte Messpunkte nicht trivial ist. Zusätzlich müssen die Resultate auch entsprechend bewertet und in Kontext gesetzt werden. Beispielsweise erzählt eine langsame API-Abfrage für einen Artikel eine andere Geschichte als ein langsames Login-Request, bei dem das Passwort gehasht werden muss.
Fazit
Qualität entsteht nicht durch Zufall, sondern durch kontinuierliches Messen, Testen und Verstehen. Mit Grafana k6 lassen sich Qualitätsziele nicht nur definieren, sondern kontinuierlich und automatisiert gegen die Realität validieren. In Kombination mit Grafana Dashboards werden diese nicht nur messbar, sondern auch sichtbar.
Gerade im Kontext von KI-gestützter Entwicklung wird dieser kontinuierliche Feedback-Loop immer wichtiger. Wenn Code vermehrt automatisiert erzeugt wird, muss die Qualität systematisch und reproduzierbar überprüft werden. Lasttests leisten hier einen entscheidenden Beitrag, um sicherzustellen, dass Performance-Anforderungen dauerhaft eingehalten werden und keine unerwarteten Probleme in Produktion auftreten.
Erfolgreiche Teams behandeln Qualität daher nicht als einmalige Aufgabe, sondern als kontinuierlichen Prozess mit ständigem Feedback. Ohne diese kontinuierliche Rückkopplung wird Performance schnell zur Blackbox mit entsprechendem Risiko für unerwartete Probleme im produktiven Betrieb.
Schreiben Sie einen Kommentar